Radar de Tendencias Aeroespaciales
 Python
 FastAPI
 LangGraph
 Hugging Face
 PostgreSQLpgvector
 TypeScript
 Next.js

 AI SDK
 Tailwind CSS
 Docker
 Coolify
El Radar Estratégico de Tendencias Aeroespaciales le ahorra a un analista de seguridad y defensa leer miles de documentos a mano para entender tres fenómenos: la inteligencia artificial en entornos militares, la seguridad del entorno espacial y la órbita baja, y las dinámicas territoriales en América Latina y el Caribe. Responde preguntas en lenguaje natural, mueve un tablero interactivo para mostrar la respuesta y lleva cada cifra al fragmento exacto de donde salió. Lo construimos como el equipo Aphelion en la Codefest Ad Astra 2026, la hackathon de la Fuerza Aeroespacial Colombiana y la Universidad de los Andes, en dos etapas: primero una base de conocimiento multilingüe sobre el corpus del reto y después, encima, el sistema multiagente y el tablero. Quedamos finalistas.
El Reto en Dos Etapas
La organización entregó a todos los equipos el mismo corpus: 1.826 archivos sobre los tres fenómenos, de centros de pensamiento de defensa, agencias espaciales y la Defensoría del Pueblo. Cada etapa se calificó por separado, y la forma de calificar explica casi todas las decisiones que siguen.
- Etapa 1 — la base de conocimiento. Responder 50 preguntas en español sobre un corpus mayoritariamente en inglés, con los 3 documentos y los 10 fragmentos más relevantes de cada una. Los fragmentos se medían con NDCG@10 y los documentos con F1@3, en dos clasificaciones independientes combinadas por Conteo de Borda. No se permitía ningún modelo generativo en la indexación ni en la recuperación.
- Etapa 2 — el radar. Dos retos sobre ese índice. El asistente (
POST /chat) se calificaba por calidad de la respuesta (relevancia, fidelidad, toxicidad y tono), eficiencia (tokens, llamadas al modelo y latencia, normalizados contra los demás equipos), seguridad (el 75% atacando el endpoint desplegado con prompt injection) y diseño. El tablero se calificaba sobre todo por la ejecución dinámica: que el agente active el componente correcto con los datos correctos ante cada pregunta. - Reglas duras en las dos: toda afirmación visual trazable a su
doc_idychunk_id, ningún índice de riesgo inventado, ninguna credencial en el código y un presupuesto de 100 USD en modelos. Si se agotaba, la clave dejaba de responder y no había demo.
Etapa 1: la Base de Conocimiento
Arquitectura Central
- Lenguaje: Python 3.12, con un único
generador.pyautónomo que reproduce la entrega desde los índices persistidos - Encoders:
BAAI/bge-m3eintfloat/multilingual-e5-large, los dos encoders XLM-RoBERTa con licencia MIT, cargados consentence-transformers - Índice: FAISS
IndexFlatIPsobre vectores normalizados, uno por encoder, con unmetadata.jsonlalineado línea a línea - Ingesta: PyMuPDF para los PDF, OCR con Tesseract para los informes escaneados y
pysbdpara segmentar oraciones según el idioma detectado - Evaluación: un ground truth propio sobre las 50 preguntas reales, con pruebas de significancia pareadas pregunta a pregunta
Flujo de Recuperación
codificar la pregunta con cada encoder (los mismos de la indexación)
buscar en cada índice 200 candidatos
fragmentos:  ranking de BGE-M3 → realce por fenómeno → deduplicar por texto → máx. 3 por documento → top 10
documentos:  fusión convexa de los dos encoders → realce por fenómeno → agregación top-2 por fuente → top 3
validar el formato de la salida antes de escribirla
El Corpus, Medido
Medimos el corpus antes de diseñar nada. Los 1.826 archivos se reparten en 759 PDF (131,6 millones de caracteres de texto extraído), 954 JSON, 73 teselas de mapa PBF, 26 CSV (111,9 millones de caracteres por sí solos), 6 libros XLSX y unas pocas imágenes y textos planos. Cuatro hechos condicionaron el diseño:
- 60 PDF no tenían capa de texto. 48 eran informes escaneados de la Defensoría que responden directamente las preguntas 33 a 50, así que el OCR era obligatorio.
- Asimetría de idioma. Las 50 preguntas están en español; el 87% del corpus está en inglés, con algo de portugués. La recuperación entre idiomas era el problema central, no un caso borde.
- Tamaños extremos. Alertas JSON de 1.300 caracteres conviven con atlas de cientos de páginas.
- 59 nombres de archivo se repiten en 186 archivos con contenido distinto, verificado por hash. Eso cambia cómo deben contarse los documentos para el F1@3.
El índice final tiene 64.484 fragmentos de 1.813 documentos.
Chunking
Los fragmentos se construyen acumulando oraciones completas hasta un presupuesto de tokens, así que ninguna oración cruza una frontera, con un solape del 15% hecho de las últimas oraciones enteras del fragmento anterior. La segmentación corre por documento en su idioma detectado; el portugués se mapea al segmentador inglés porque pysbd lo rechaza, y sin ese mapeo sus 7.617 fragmentos caían a un camino que trataba cada párrafo como una sola oración.
Dos decisiones salieron de medir:
- Tope de 400 fragmentos por archivo tabular. 30 archivos CSV/XLSX producían el 61% de los 149.571 fragmentos iniciales, y tres exportaciones bibliográficas de PubMed se llevaban solas el 51,5%: referencias biomédicas ajenas a todas las preguntas, que consumían la mitad del tiempo de codificación y competían en cada búsqueda. Los PDF largos y legítimos no se tocan, y ningún archivo se excluye, porque el documento tiene que seguir siendo alcanzable.
- Chunking jerárquico, probado y descartado. Cortar por encabezados detectados obtuvo NDCG@10 de 0,3602 frente a 0,4879 del chunking por oraciones sobre la misma muestra, el peor de todos los que probamos: detectar encabezados no es fiable en un corpus con formatos tan dispares.
Cómo Elegimos los Encoders
El criterio decisivo fue la recuperación entre idiomas. BGE-M3 se entrena explícitamente para ella (67,8 nDCG@10 en MIRACL sobre 18 idiomas, frente a 65,4 de mE5-large) y tiene una ventana de 8.192 tokens; mE5-large tiene 512. Los dos son encoders, como exigía el reglamento: todo modelo derivado de un backbone autorregresivo (Qwen3-Embedding, e5-mistral) quedaba fuera por mucho que liderara MTEB, y Jina v3 quedaba fuera por su licencia no comercial.
Comparamos siete encoders sobre una muestra con ground truth propio. multilingual-e5-base quedó muy por debajo (NDCG@10 de 0,2503), gte-multilingual-base no superó al par principal pese a venir de otra familia de preentrenamiento, y LaBSE, que entró como control porque se entrenó para alinear frases paralelas y no para juzgar relevancia, confirmó la hipótesis perdiendo.
Una trampa de configuración que vale la pena contar: BGE-M3 toma el token CLS y mE5-large promedia con la máscara de atención. Usar por descuido mean pooling en BGE-M3 baja el coseno contra la referencia de 0,999999 a 0,81, un error que parece numérico y es de configuración.
Una Política por Métrica
Nada en el reglamento obligaba a que fragmentos y documentos salieran del mismo ranking, y medido sobre el corpus completo no conviene:
- BGE-M3 solo, top-2: NDCG@10 0,7329, F1@3 0,7000
- BGE-M3 + mE5-large, fusión convexa, top-2: NDCG@10 0,6597, F1@3 0,7547
- BGE-M3 + mE5-large, RRF, top-2: NDCG@10 0,6255, F1@3 0,7413
- Adoptada, fragmentos de BGE-M3 y documentos por fusión convexa: NDCG@10 0,7329, F1@3 0,7547
Fusionar los fragmentos costaría 0,0732 de NDCG@10 (p = 0,0012); no fusionar los documentos costaría 0,0547 de F1@3. mE5-large aporta documentos que BGE-M3 no trae, pero ensucia el orden de los fragmentos. La fusión convexa normaliza cada encoder por consulta con min-max antes de sumar, porque mE5-large comprime sus similitudes entre 0,75 y 0,92 mientras BGE-M3 se mueve más abajo, y a diferencia de RRF conserva el tamaño de una ventaja en vez de reducirla a una posición.
Fuimos explícitos con los límites: la ganancia de F1@3 por sí sola no es significativa (p = 0,1215). La mantuvimos porque contra nuestro ground truth su costo es exactamente cero, ya que la lista de fragmentos no cambia, y porque el efecto apuntaba en la misma dirección en todas las variantes de fusión que probamos.
Reglas de Ranking, Cada Una Medida
- Realce por fenómeno (×1,05), no filtro duro. Las preguntas 5 y 46 tratan Colombia desde fenómenos distintos, y la 27 cruza IA con operaciones espaciales; un filtro duro dejaría fuera evidencia válida.
- Deduplicación por texto. El 6,9% de los fragmentos repite uno ya indexado (tablas reimpresas, encabezados institucionales). Dos copias gastarían dos de las diez posiciones para decir lo mismo. Los duplicados se quitan de la lista de fragmentos, no de la agregación a documento, donde descartar uno podría dejar inalcanzable un documento distinto.
- Máximo 3 fragmentos por documento. Sin el tope, un solo documento equivocado puede llevarse las diez posiciones y hundir la pregunta.
- Documentos puntuados por top-2 y agrupados por fuente. La puntuación de un documento es la media de sus dos mejores fragmentos: sumar favorece a los documentos largos (cuarenta fragmentos de 0,15 suman 6,0 y entierran un informe corto con la respuesta exacta a 0,85), y top-2 subió el F1@3 del fenómeno 2 de 0,7708 a 0,8750 frente a
max. Agrupar por archivo de origen y no pordoc_idevita que dos copias del mismo archivo ocupen dos de las tres posiciones.
Resultados
Contra nuestro propio ground truth: 1.383 juicios graduados de fragmento sobre 265 documentos (relevancia 0/1/2), con el pool sacado de la unión del top 15 de cada encoder, para no sesgar la medida hacia lo que la configuración actual ya encuentra.
- Global (50 preguntas): NDCG@10 0,7329, F1@3 0,7547
- Fenómeno 1, IA en entornos militares: NDCG@10 0,6658, F1@3 0,6042
- Fenómeno 2, seguridad espacial: NDCG@10 0,8382, F1@3 0,8958
- Fenómeno 3, dinámicas territoriales: NDCG@10 0,6988, F1@3 0,7630
El fenómeno 1 es el más flojo en las dos métricas, y lo explica el corpus: 6,4 documentos relevantes por pregunta frente a 9,9 del fenómeno 2. Hay menos que encontrar.
Medido y Descartado
- Realimentación de pseudo-relevancia (Rocchio) sobre una rejilla de 14 configuraciones: la mejor subió el NDCG@10 de 0,4879 a 0,5034 con p = 0,047, que no sobrevive a la corrección por comparaciones múltiples, y dañó el F1@3 en las ocho configuraciones con fusión. Queda implementada y desactivada.
- Profundidad del pool de candidatos: el F1@3 sube de forma sostenida hasta 200 candidatos y se aplana después (de 400 a 3.200 no aporta nada), así que 200 es donde satura, no una cifra heredada.
- Índices aproximados (IVF, HNSW): 64.484 vectores de 1.024 dimensiones ocupan unos 252 MB por encoder y la búsqueda exhaustiva sobre 50 preguntas termina en segundos. La Etapa 1 medía calidad, no velocidad, así que cualquier recall perdido era puro costo.
- El grafo de conocimiento opcional: dedicamos ese tiempo a medir la política de recuperación, que es lo que la etapa evaluaba.
Etapa 2: el Radar Multiagente
Arquitectura Central
- Orquestación de agentes: LangGraph, con seis agentes en un grafo con enrutado condicional y un ciclo de verificación con tope
- Backend: FastAPI + asyncpg; un solo proceso sirve el endpoint
POST /chatdel reto, un stream SSE y la API de agregación del tablero - Modelos:
gpt-oss-120bpara enrutar, descomponer y redactar, ygpt-oss-20bpara los guardianes, el visualizador y el verificador, a través de un proxy LiteLLM compatible con OpenAI - Recuperación: los vectores BGE-M3 de la Etapa 1, llevados a PostgreSQL 18 + pgvector detrás de un índice HNSW, para que una consulta cruce vectores y metadata sin salir de la base
- Frontend: Next.js 16 + TypeScript + MapLibre + Recharts + AI Elements; la misma imagen sirve el tablero y el chat según
NEXT_PUBLIC_SURFACE - Contrato: modelos de respuesta en Pydantic, con los tipos del frontend generados desde el OpenAPI del backend
- Despliegue: tres recursos en Coolify con Dockerfile, imágenes sin root y
HEALTHCHECK
Arquitectura en Capas
El tablero y el chat son dos despliegues de la misma imagen de frontend, y detrás hay un solo backend. Las tools del agente y los componentes del tablero consultan exactamente los mismos endpoints de agregación, así que una cifra no puede decir una cosa en el chat y otra en el mapa. Separarlos habría significado mantener dos veces la misma agregación y arriesgar que divergieran. Son dos despliegues distintos a propósito: el asistente se evaluaba en una ventana cerrada, y redesplegar el tablero no podía tumbar el chat.
Flujo de una Petición
Grafo de Agentes
Seis agentes en un grafo de LangGraph. Tres son el mínimo que pedía el reto; los otros tres son de seguridad y verificación, porque la resistencia a ataques se medía atacando el sistema desplegado. Cada salida temprana (un ataque, un saludo, una pregunta sin evidencia) termina el recorrido sin gastar las llamadas que ya no hacen falta.
input_guardrail(modelo pequeño): clasifica el mensaje antes de que entre al grafo, así que un ataque directo se corta antes de pagar el modelo grande.orchestrator(modelo grande): elige la ruta y descompone la pregunta en formulaciones de búsqueda, en una sola llamada.rag_analyst(modelo grande): recupera y redacta con la evidencia; es el razonamiento real del sistema.visualizer(modelo pequeño): elige los componentes del tablero que responden la pregunta y sus filtros. Elegir qué mirar no es redactar, así que solo lo pagan las preguntas que lo necesitan.verifier(modelo pequeño): revisa fidelidad, trazabilidad e inyección indirecta. Auditar es más fácil que redactar.output_guardrail(modelo pequeño): toxicidad e instrucciones filtradas, la última barrera sobre un texto que ya escribió un modelo.
Cuando el verificador rechaza una respuesta, el orquestador reformula con el motivo delante y el analista vuelve a recuperar y a redactar, como mucho dos veces. Pasado ese tope, la respuesta sale con el estado no_verificada, declarado y sin fallar.
Tres Rutas, Decididas en una Sola Llamada
text: solo corre el analista, para explicaciones, doctrina, causas y contexto.visualization: solo corre el visualizador, para una cifra repartida en el espacio, en el tiempo o entre categorías. Esta ruta se salta el verificador, porque no hay fragmentos recuperados cuyas citas revisar; el guardián de salida sí corre.both: las dos ramas corren en paralelo y se reencuentran en el redactor, así que elegir los componentes no suma latencia de reloj.
Ante cualquier fallo, la ruta vuelve a text, que es lo que el sistema ya hacía. Si la ruta visual no produce ningún componente válido, la respuesta sale igual del corpus y dice que no se pudo preparar la visualización.
Seguridad por Capas
Los ataques directos los frena casi siempre la propia alineación del modelo. El que de verdad pasa es el indirecto: una instrucción que viaja dentro de un fragmento recuperado, porque el corpus tiene documentos que nadie escribió pensando en un asistente. Cada capa cubre lo que la anterior no puede:
- Clasificador de entrada: anulación de instrucciones, extracción del prompt de sistema, suplantación y jailbreaks.
- Contexto recuperado entre delimitadores y declarado como datos: la defensa que de verdad para la inyección indirecta.
- Un redactor sin herramientas: un fragmento envenenado no tiene ninguna acción que invocar.
- Verificación de citas en código: referencias inventadas, que un prompt no puede evitar.
- Clasificador de salida: toxicidad y fugas del prompt de sistema.
- Un tope duro de iteraciones: agotamiento del presupuesto.
- Credenciales solo por variable de entorno: ningún secreto en el repositorio ni en la imagen, que es lo que revisaba el análisis estático.
Un Contrato de Respuesta que No Puede Desviarse
Los modelos de respuesta siguen campo por campo la especificación del reto, todos con extra="forbid", y la respuesta se arma en un solo sitio a partir del estado final del grafo, venga por donde venga, así que ningún camino puede devolver un campo de más o de menos. Los tokens se acumulan por agente y no por modelo (dos agentes comparten modelo), num_interacciones cuenta llamadas al modelo y la latencia se mide alrededor del recorrido del grafo. Todo fallo devuelve igualmente el contrato completo con su estado, nunca un 500 a secas: durante la ventana de evaluación, una petición fallida era una pregunta perdida y sin reintento. Un error interno nunca se reporta como sin_evidencia, porque decir que el corpus no tiene evidencia cuando lo que se cayó fue el proxy sería una afirmación falsa sobre el corpus.
Características Principales
Las Tools de un Vistazo
El asistente mueve el tablero
Una pregunta que pide ver algo (dónde, cuándo, con quién, qué domina) pasa por el agente visualizador, que no redacta: elige de uno a tres componentes y sus filtros. Nunca elige los datos, que salen de los mismos endpoints de agregación que pintan el tablero, y todo lo que devuelve se valida en código contra listas cerradas, así que una tool, un campo o una entidad que no existen se descartan. El componente se deduce del nombre de la tool, que ya viaja en la respuesta del agente, así que coordinar el tablero no cuesta ni un token adicional y añadir un componente es añadir una tool. Si la pregunta nombra un territorio, el código lo resuelve contra la tabla de lugares, y el mapa lo encuadra y abre su evidencia como si se le hubiera hecho clic.
Un componente para cada tarea analítica
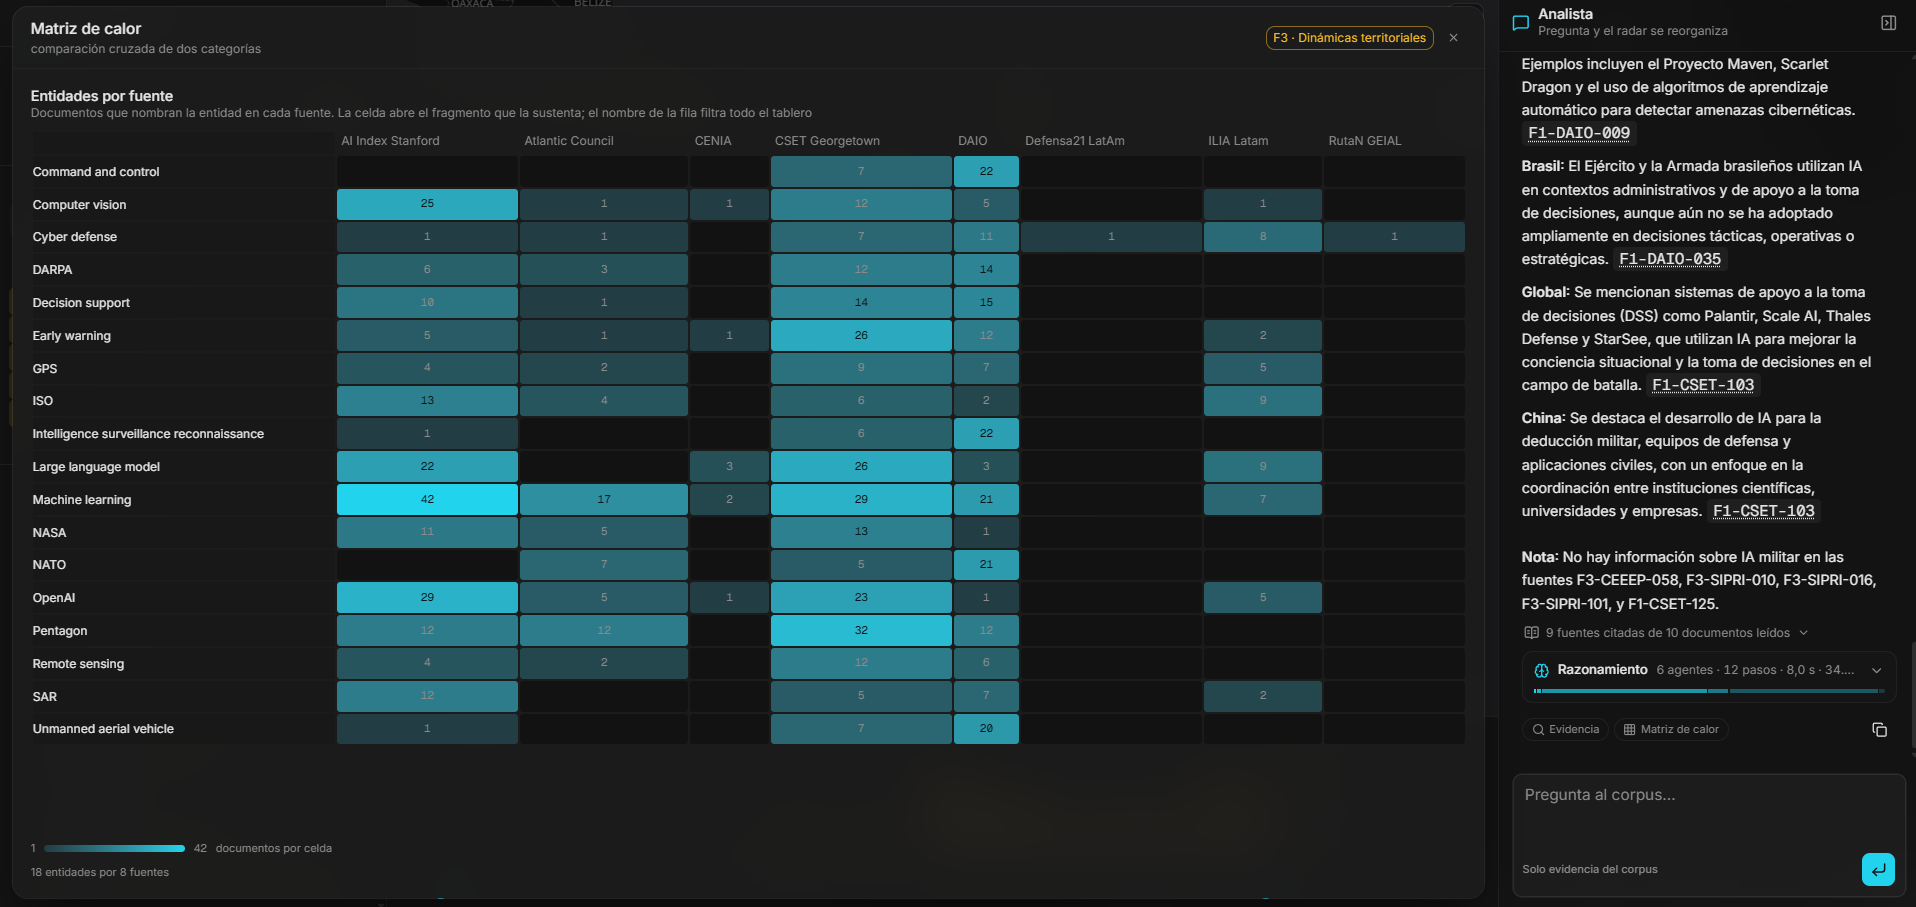
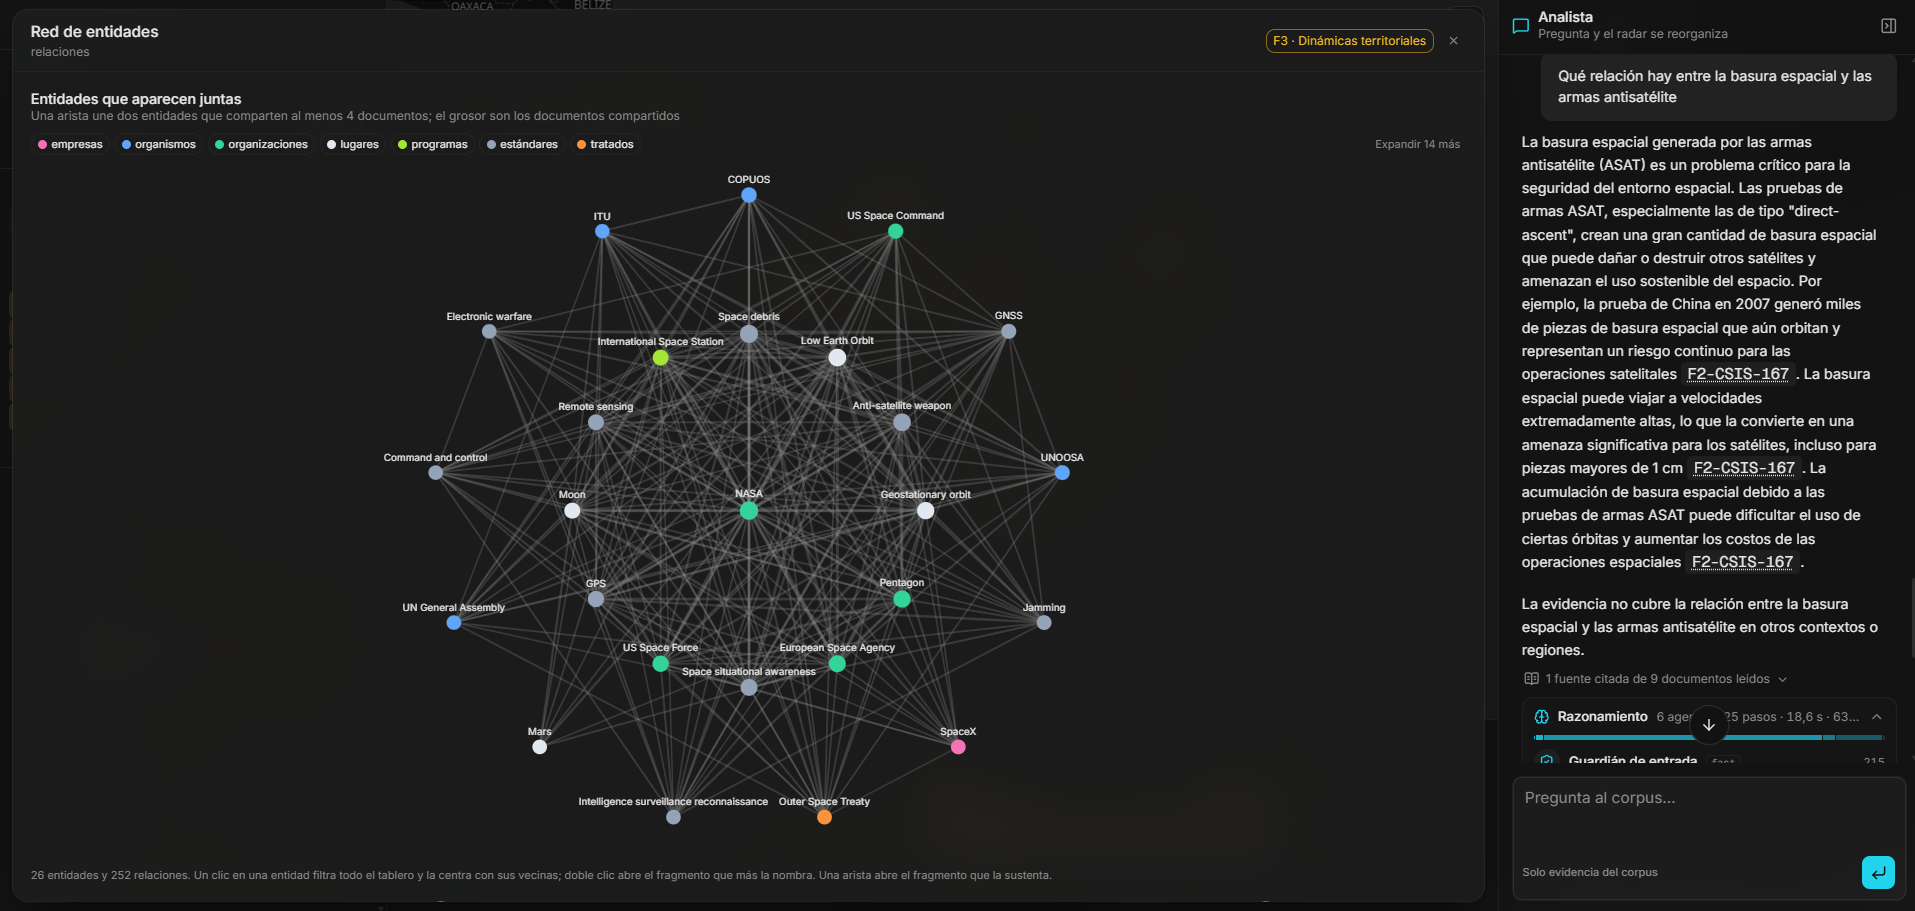
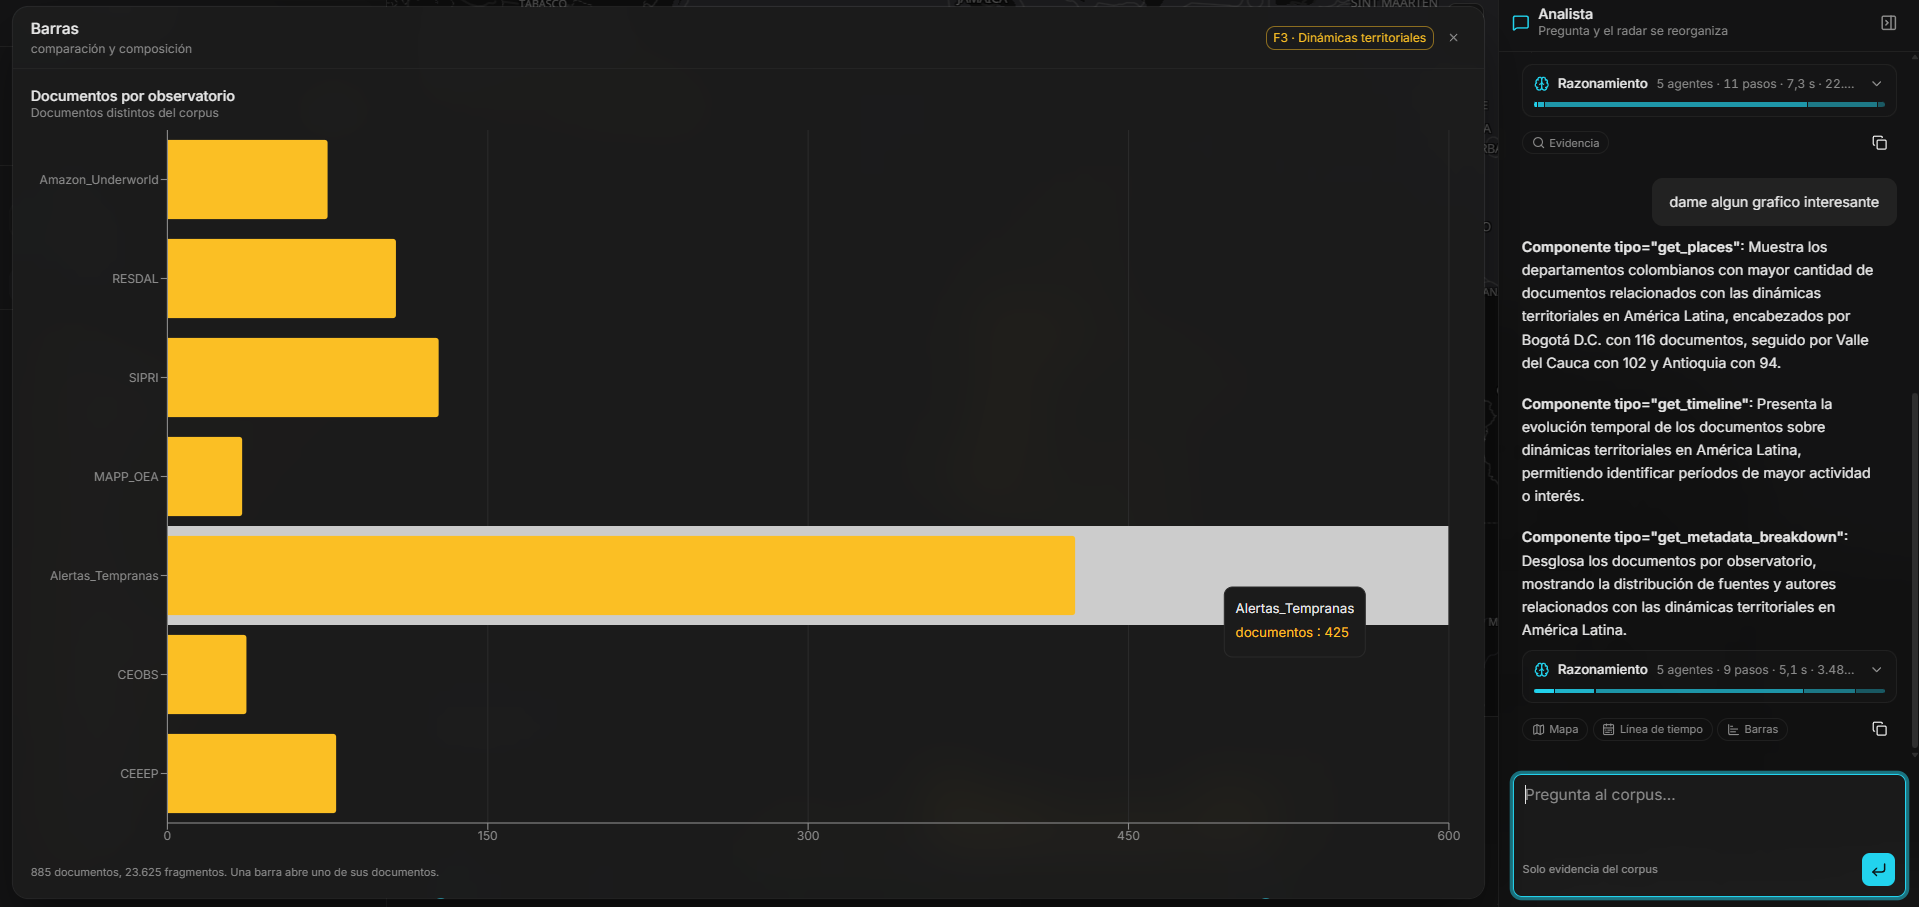
Los componentes se eligieron al revés de lo habitual: primero las preguntas que cada fenómeno hace razonable responder y después el gráfico que las contesta. Las comparaciones van en barras, las comparaciones cruzadas en una matriz de calor, las relaciones en una red de co-ocurrencia, la distribución espacial en un coroplético, las tendencias en una línea de tiempo y la verificación en el panel de evidencia.
- IA en entornos militares es un fenómeno de actores y programas, no de territorio, así que sus vistas principales son la matriz de calor y la red de co-ocurrencia.
- Seguridad espacial es un fenómeno de agenda: qué preocupaciones crecen y cuáles se consolidan. Su vista principal es un cuadrante de intensidad contra tendencia, con la línea de tiempo.
- Dinámicas territoriales es el único fenómeno con territorio explícito, así que manda el coroplético, con la red y el panel de evidencia al lado.
Un mapa, tres preguntas distintas
El mapa no superpone capas: cada vista es una pregunta distinta sobre un territorio distinto, y mezclarlas produciría un color que no significa nada.
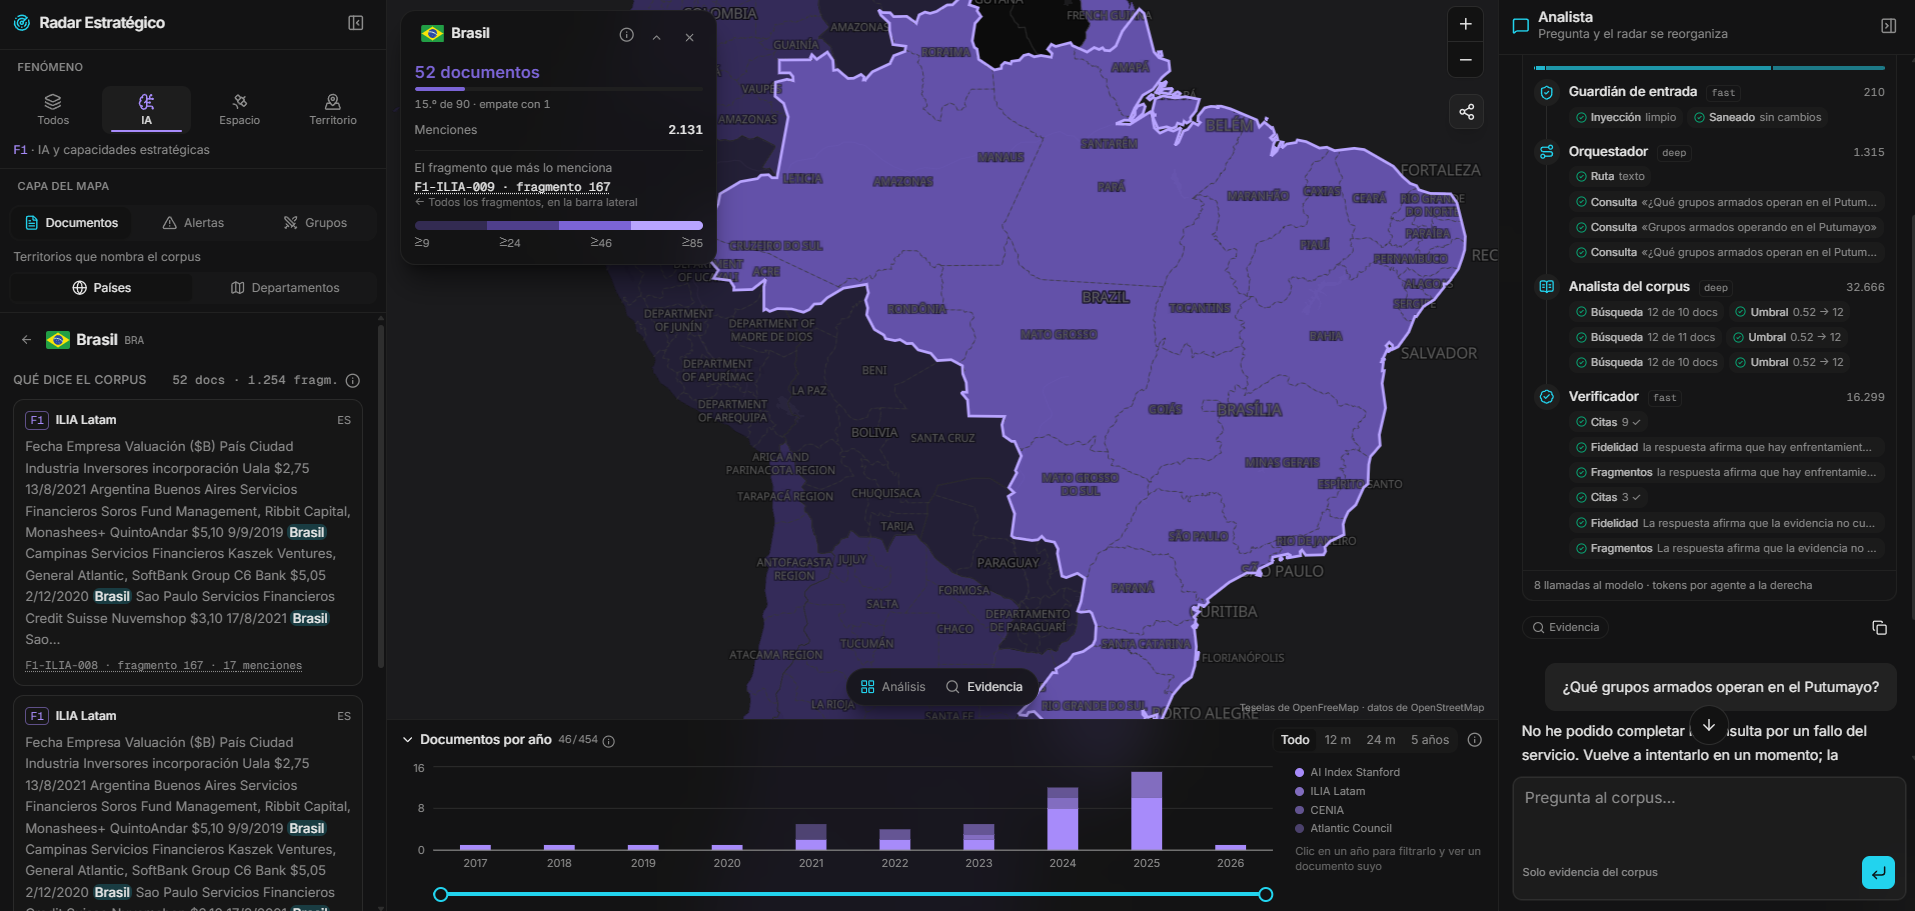
- Documentos: cuántos documentos del corpus nombran cada país o departamento. Nombrar no es actuar.
- Alertas: qué departamentos nombran las 363 alertas tempranas de la Defensoría (2017–2026), separadas en riesgo inminente y estructural, nunca sumadas.
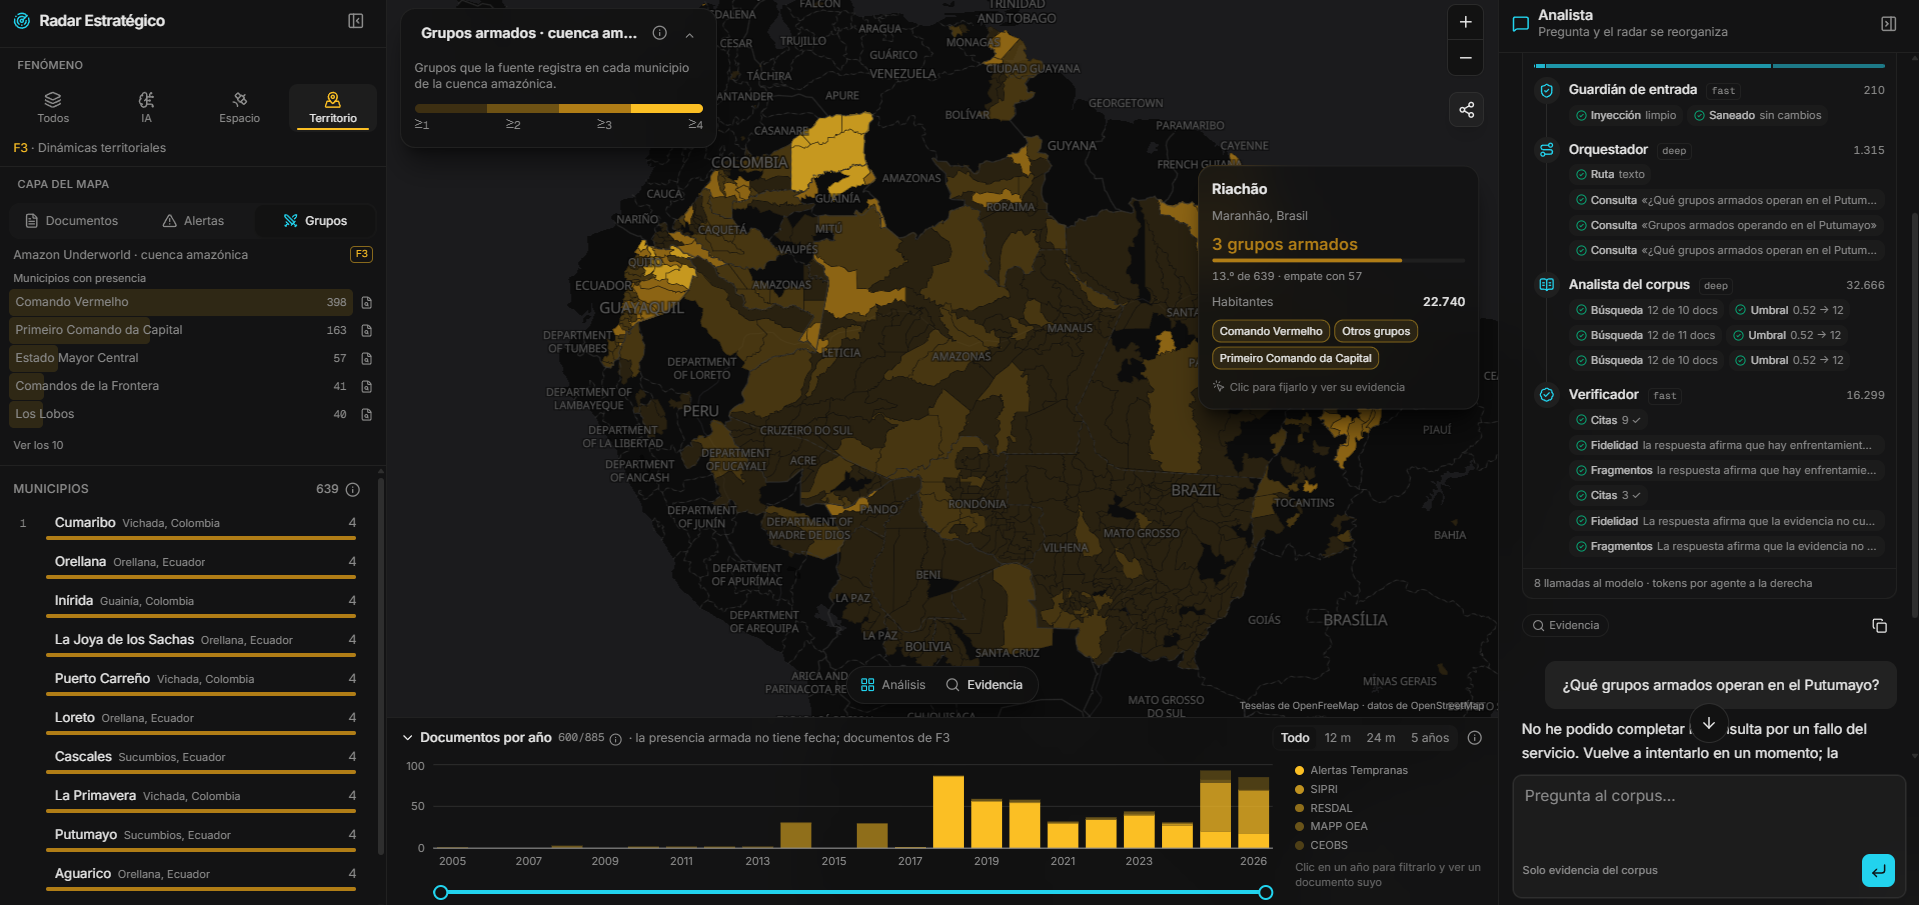
- Grupos armados: qué grupos hay en cada uno de 1.407 municipios de seis países amazónicos, según el dataset público de Amazon Underworld. Es presencia declarada, no intensidad, y un municipio sin información nunca se muestra como uno sin presencia.
La presencia armada se pinta municipio a municipio porque ese es el nivel en el que mide la fuente: agregarla al departamento borraría la diferencia entre un municipio con cuatro grupos y uno sin ninguno. La geometría municipal no sobrevivió a la indexación de la Etapa 1, así que se toma de geoBoundaries y se cruza por nombre, y cuando un nombre se repite desempata el departamento que contiene el centro del polígono: 1.385 de los 1.407 municipios (98%) encuentran su forma.
Ninguna cifra sin fuente
Cada barra, celda, año, nodo o territorio del tablero trae con su cifra el doc_id y el chunk_id de un fragmento que esa cifra cuenta. Un clic abre el documento en ese fragmento, con cada mención resaltada con las mismas formas que contó el precómputo. La vista del documento sirve una ventana de 80 fragmentos centrada en la cita y no el documento entero; el mayor tiene 1.960 fragmentos. El sistema cuenta y agrega, pero nunca calcula un índice de riesgo propio: el reglamento lo prohibía, y un número sin fuente no le sirve a quien tiene que decidir con él.
Filtros que viven en la URL
El fenómeno, el periodo y la entidad seleccionada se propagan a todas las vistas y quedan en la URL, así que cualquier vista se comparte tal cual y el botón de atrás funciona. Elegir una entidad en la matriz, la red o el cuadrante reduce las demás vistas a los documentos que la nombran. El filtro de periodo es mensual, pero solo 212 documentos traen fecha completa, así que un documento entra solo cuando toda su fecha conocida cae dentro del periodo. El botón de compartir compone una tarjeta con la vista (mapa, filtros, leyenda, ranking y fuente) en vez de una captura de pantalla a secas.
Razonamiento visible
Cada respuesta enseña sus citas enlazadas, las fuentes que leyó y el razonamiento: qué agentes participaron, en qué orden, con qué modelo, cuántos tokens gastaron y qué devolvió cada herramienta. Mientras el grafo corre, el frontend recibe cada nodo por SSE en cuanto termina.
Destacados Técnicos
El redactor no tiene herramientas
Recuperar y redactar son dos nodos separados. El que redacta recibe texto y devuelve texto, así que un fragmento envenenado no tiene nada que invocar aunque consiga engañar al modelo. Es la única defensa que detiene la inyección indirecta por construcción. Por la misma razón el modelo no decide si buscar: toda pregunta sobre el contenido necesita evidencia, así que preguntárselo sería pagar una llamada por una respuesta que ya se conoce.
La trazabilidad se comprueba en código
Saber si un identificador citado está entre los fragmentos recuperados es comparar dos conjuntos: exacto, gratis y sin fallos, así que no se le pregunta a un modelo. Una lección medida: gpt-oss-120b escribe las citas con el guion no separable (U+2011) y con espacios dentro de los corchetes. Con el patrón ingenuo no se extraía ninguna cita y la respuesta pasaba la verificación sin que nadie hubiera mirado sus fuentes, que es peor que no tener la comprobación. Ahora se normalizan guiones y espacios antes de extraer.
Un presupuesto en dinero, no en tokens
Con 100 USD para todo el evento, lo que no es razonar va al modelo pequeño, todas las llamadas usan reasoning_effort: "low" (en un simple «di hola», 23 de los 33 tokens de salida eran razonamiento) y los saludos o preguntas ajenas al corpus se responden sin recorrer el grafo. max_tokens nunca se ajusta: estos modelos razonan antes de responder, y con el margen justo gastan el presupuesto razonando y no emiten nada. Medido de punta a punta: una pregunta completa son 6 llamadas, unos 33.000 tokens y 17 s; un ataque muere en la primera capa con 1 llamada, 344 tokens y 1,2 s.
Enrutar no cuesta llamadas
El orquestador decide la ruta en la misma llamada con la que descompone la pregunta, como un campo más del JSON que ya devolvía. Así la ruta de texto gasta exactamente lo mismo que antes de que existiera el visualizador, y eso importaba porque la eficiencia se puntuaba contra los demás equipos.
Los guardianes fallan hacia el lado útil, y en silencio
Si el proxy de modelos no responde, los guardianes dejan pasar en vez de bloquear: convertir una caída del proveedor en un bloqueo general tumbaría la demo, y las otras capas siguen en pie. Cuando una entrada se bloquea, la respuesta no dice qué regla saltó, para no enseñarle al atacante cuál es su siguiente intento; el motivo queda en el log estructurado.
Datos estructurados recuperados del índice
Las capas de alertas y de presencia armada se reconstruyeron desde el propio índice, sin volver al corpus crudo: esos documentos guardaban sus campos estructurados dentro del texto indexado (b_ADM2_PCODE, au_eln, fecha_emision), así que el dato estaba en la base en forma de frase. Las entidades se extraen por diccionario y coincidencia de texto, no con un LLM: pasar 1.813 documentos por inferencia se habría comido el presupuesto, y los nombres propios no necesitan razonamiento.
Fechas de la fuente, nunca del texto
Un año mencionado dentro de un informe es el año del que habla, no el año en que se publicó, así que las fechas de publicación salen solo de la metadata de la fuente: el nombre del archivo y su carpeta en el corpus original. Cinco reglas, de la más precisa a la menos (número de alerta, año en el nombre, fecha ISO, carpeta del año y fecha compacta), y cada fila registra qué regla la produjo, así que cualquier punto de la línea de tiempo se audita hasta su archivo. 965 de 1.813 documentos quedan fechados; el resto no entra en la serie, y la línea de tiempo lo dice en su propia cabecera en vez de repartirlos.
Tendencia sin inventar un índice
El cuadrante de intensidad contra tendencia usa solo conteos verificables: cuántos documentos fechados nombran la entidad y qué proporción está en la mitad reciente del corpus. El corte es la mediana del corpus fechado, calculada y no fijada, y las líneas divisorias son las medianas de cada eje, así que el cuadrante compara entidades entre sí y no contra un umbral inventado.
Una auditoría de los datos antes de entregar
Los conteos de lugares se auditaron contra el texto. Natural Earth le da a Bogotá el código de Cundinamarca, así que cada mención de la capital contaba para el departamento; ahora Bogotá tiene su código propio. Los homónimos (un grupo armado con nombre de departamento, un tratado, una universidad) entraron como señuelos, lo que bajó a Santander de 59 a 41 documentos. Y las direcciones postales de la Defensoría, impresas en cada alerta y escritas distinto por el OCR cada vez, se quitan antes de buscar.
Estructura del Proyecto
Etapa 1, la entrega de la base de conocimiento:
generador.py          # autónomo: reproduce resultados.jsonl desde los índices persistidos
resultados.jsonl      # 50 líneas, 3 documentos y 10 fragmentos por pregunta
base_vectorial/
├── encoder_bge-m3/     # index.faiss + metadata.jsonl, la línea n describe el vector n
└── encoder_me5-large/  # lo mismo para multilingual-E5-large
informe_tecnico.pdf   # informe técnico: diseño, mediciones y el porqué de cada decisión
requirements.txt      # versiones fijadas, verificadas en un entorno limpio
Etapa 2, el radar:
backend/
├── app/
│   ├── agent/        # grafo de LangGraph: guardianes, orquestador, analista, visualizador, verificador
│   ├── api/          # POST /chat, el stream SSE y los endpoints de agregación del tablero
│   ├── db/           # consultas por componente (lugares, línea de tiempo, entidades, cuadrante…)
│   └── responses.py  # el contrato de respuesta del reto, validado con extra="forbid"
├── precompute/       # entidades, lugares, fechas, presencia armada, alertas y municipios, calculados una vez
├── scripts/          # genera agent_card.json desde la declaración de agentes
└── tests/            # guardianes, verificador, enrutado y el grafo de punta a punta con mocks
frontend/
├── app/              # Next.js 16 App Router
├── components/       # mapa, componentes de análisis, chat, línea de tiempo y registro de componentes
└── lib/              # cliente de la API con tipos generados del OpenAPI, filtros y estado en la URL
docs/arquitectura.md  # el diseño del sistema y el porqué de cada decisión
Impacto y Escalabilidad
- Finalista de la Codefest Ad Astra 2026, con la Etapa 2 construida y desplegada en 24 horas de desarrollo presencial.
- Un índice, dos etapas: los vectores construidos y medidos en la Etapa 1 son los que consultan los agentes de la Etapa 2, así que la calidad de la recuperación estaba resuelta antes de escribir un solo prompt.
- Reproducible por diseño: el generador de la Etapa 1 corre desde su propia carpeta con semillas fijas y versiones ancladas, y una prueba automática lo compara con la implementación de desarrollo para que las dos no diverjan en silencio.
- Añadir un componente es añadir una tool y su entrada en el registro: el frontend lo deduce del nombre de la tool.
- Cambiar de proveedor de modelos son cuatro variables de entorno, no código: el gateway del reto y uno de desarrollo hablan el mismo dialecto.
- Los tipos del frontend se generan del OpenAPI, así que un cambio en una respuesta del backend no se escribe dos veces.
- Tests de los guardianes con casos conocidos de inyección, del verificador y del grafo completo de punta a punta con el proxy y el índice mockeados.
Notas
Construido con Python, FAISS, LangGraph, FastAPI, PostgreSQL + pgvector y Next.js. El código de las dos etapas es público: Etapa 1 (la base de conocimiento y su informe técnico) y Etapa 2 (los agentes y el tablero). El corpus lo entregó la organización solo para el evento, así que esta página muestra la solución, no los datos.